
我把一件本來自己做的事,拆成 10 個 agent 同時做。任務沒變難、模型沒換、每個 agent 也都把自己那份做完了——然後整個 session 撞到上限停住。
分工照理說要讓每個人的負擔變小。這裡卻是反過來的:拆得越開,撞牆撞得越快。Day 1 最後留下的那個缺口——「容量」——就是從這裡裂開的。
那次的工作是逐頁目視一批頁面,規則寫死、沒有判斷空間,看起來是最適合平行的那種任務。我開了 10 個同級模型的 agent,一人一段頁數。
結果記在我自己的 CLAUDE.md(供 Claude Code 讀取專案規則的檔案)裡,是一條事後補上的硬規則:同級模型 10 個目視 agent,各 40–57 萬 tokens,曾觸發 session limit。
這行字裡最刺眼的不是「session limit」,是「各 40–57 萬」。每一個 agent 單獨看都不離譜——它只是把分配到的頁看完、照格式記下來。沒有誰失控。失控的是總和。
而總和之所以會是總和,是因為它們全都活在同一個 session 裡。
十個 agent 各自 40–57 萬,加起來是數百萬 tokens 的量級。但我當時沒有任何一個地方會顯示這個總和:每個 agent 的視角裡只有自己分到的那幾頁,我的視角裡只有「十個都在跑」,中間沒有一個位置負責把十份用量加起來。Day 1 那張圖裡的橘色框到這裡還在——所有判斷仍然收在同一個點上,只是這次塞進來的不是四筆 commit,是十份同時進行的工作。
先看用量長什麼樣子。我的逐輪用量紀錄按 session 彙總每一輪的花費(這份紀錄未公開),排出前幾名之後,分佈長這樣:
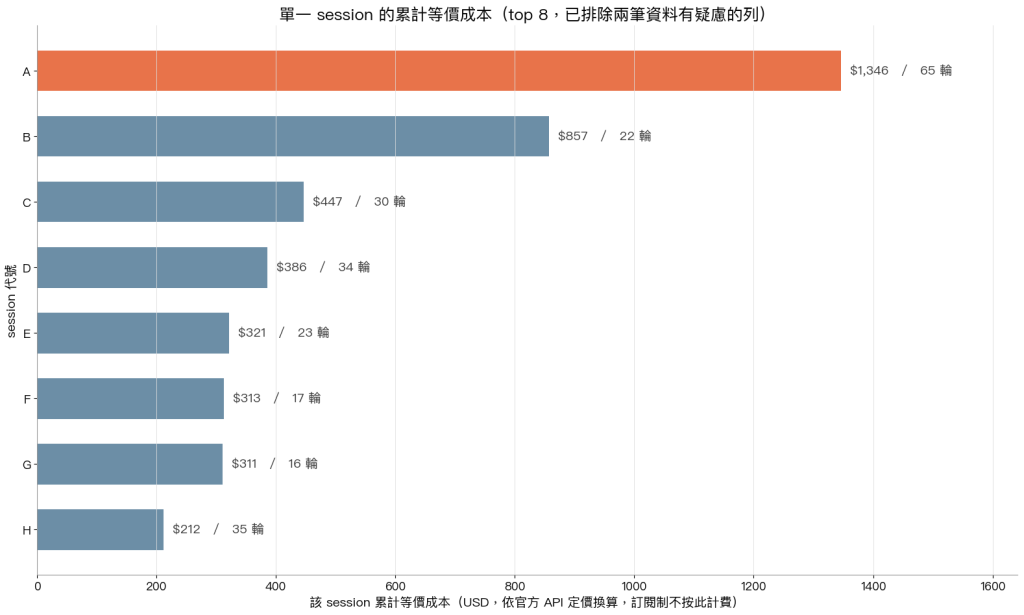
單一 session 累計等價成本前八筆;原始彙總列的模型欄記為 fable-5-1 或 claude-fable-5-1,不據此保證各 session 全程只用同一模型。金額沿用逐輪用量紀錄按記錄時 API 定價換算的美元等價成本,並非訂閱實付;本次盤點未附完整費率版本,不能外推其他模型或今日價格。另有兩列暫不納入、待主控複核:一列輸出疑似欄位錯位,另一列快取讀取量與輸入量加總皆為 0;尚未確定原因。
圖中的 session A 記錄 65 輪、累計等價成本約 1,346 美元;session B 記錄 22 輪、約 857 美元,顯示輪數本身不足以解釋總成本。這些排行樣本尚未與開場十個目視 agent 的事故建立同一場 session 的對應,不能拿來還原事故帳單;它們只提供另一個觀察入口:主控每輪承接了多少工作與回報。
那單價花在哪?2026-09-01 我做過一次用量拆解,當時的筆記記載:主控自己吃掉該次分析等價成本的 58.8%、119.10 美元、cache read(快取讀取量)71.5M tokens。派出去的那些 agent 加起來,反而不是大頭。
同一筆記錄裡還有兩個數字,解釋了主控為什麼這麼貴(這兩個數字引用當時的筆記,原始對話紀錄已經遺失,無法重算驗證):
把這兩件事疊起來,就是下面這張圖:
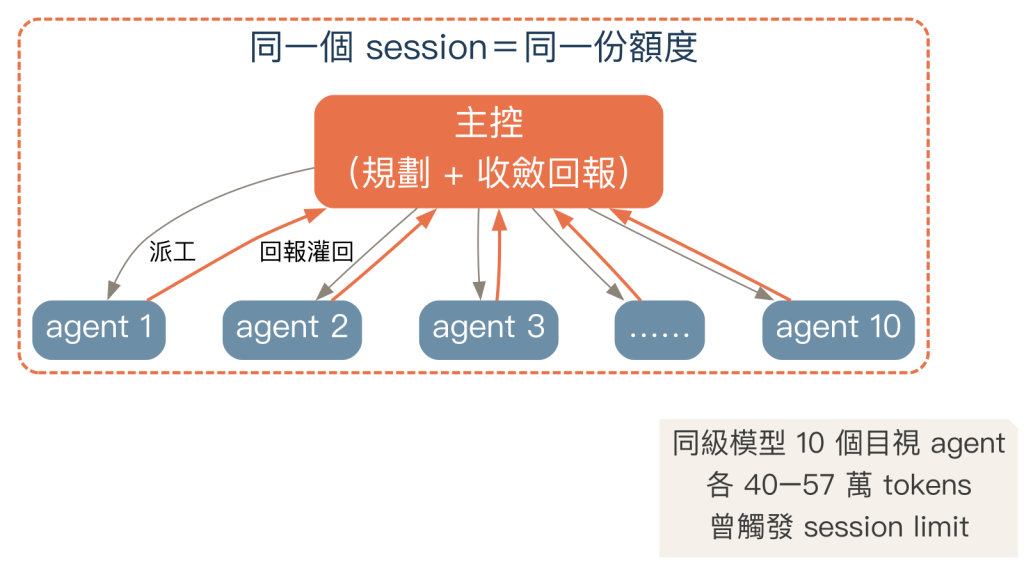
派工的箭頭是發散的,回報的箭頭全部收斂到同一個點;而整個虛線框——包含所有 agent——共用同一份額度。
所以開頭那個矛盾的答案是:分工並沒有把負擔分掉。它只是把「做事」這件事分掉了,「知道大家做了什麼」這件事一點都沒分掉,全部堆回主控身上。27 則 × 8691 字元進到同一個對話裡,而主控自己還在跑 140 次 Bash。
我的判讀是,這裡需要同時管理總用量與回報流向。額度是服務允許消耗的用量預算,context 容量是單次模型請求可容納的上下文上限,累計 tokens 則是多次讀寫的總量,三者不能互換。開場紀錄只寫觸發 session limit,尚不足以判定撞到哪一種限制;也不能把十個 agent 的累計 tokens 直接當成主控單次 context 的大小。
我後來把三條規則寫死在 CLAUDE.md 裡,成本相關的判斷則記在前述 2026-09-01 的用量拆解筆記:
這三條分別限制主控親自執行的工作量、單一 agent 的任務範圍,以及回報加入主控 context 的內容量。判斷能否平行時,我開始同時問:總用量是否有預算、每份回報是否必要、主控是否還有足夠 context 空間處理後續決策。
這些是設計上的預期,我沒有在同樣條件下重跑一次那個 10 agent 的任務來對照,所以不宣稱改善了多少。三條規則都是事故之後補寫進去的,不是當時就在手上的東西。
規則寫下去之後,有個數字還是很難解釋:cache read 71.5M、單一 session cache_read 54,206,541 tokens。
cache read 顧名思義是「讀快取」——同樣的內容,重複被讀進去。22 輪的 session 能累積到 5 千多萬,代表每一輪都在重讀一份很大的東西。回報壓短只解決了「新增了什麼」,沒有解決「每一輪都要重新帶上什麼」。
額度不是被一次性的大動作吃掉的,是被每一輪都要重付一次的那份底稿吃掉的。那份底稿叫 context。
明天講它為什麼會膨脹。


 iThome鐵人賽
 看影片追技術